직원 AI 역량 평가 항목: 사용량 말고 일한 기록에서 보는 4가지
직원의 AI 역량은 사용 횟수나 'AI를 얼마나 쓰나요' 설문보다 실제로 AI를 써서 한 일의 기록으로 평가합니다. 연구들에서 AI 활용 능력의 자기평가는 시험·과제로 잰 실제 점수와 잘 맞지 않았습니다. 무엇을 AI에 맡겼는지(위임), 얼마나 분명하게 지시했는지(설명), 결과를 확인했는지(분별), 최종 판단에 책임졌는지(성실) 네 요소마다 기록을 근거로 1~4단계를 매기고, 근거가 없는 요소는 평가 면담에서 확인합니다.
피플팀을 혼자 맡고 있는데 대표가 “올해 연말평가부터 AI 활용도 보자”고 했다면, 11월 안에 평가 항목과 기준 문장을 만들어야 합니다. 8월에는 한글과컴퓨터가 성과 지표의 30% 이상에 AI를 이용한 업무 혁신을 반영하고, 삼성전자가 임원 평가에서 AX 역량 비중을 20%로 늘렸다는 보도가 나왔습니다.[7]
기준이 없으니 손에 잡히는 숫자부터 모으게 됩니다. ‘AI를 얼마나 쓰나요’ 자기평가 설문, 회사 AI 도구의 라이선스 사용량, AI 교육 이수 여부. 이 숫자들은 AI를 얼마나 켰는지는 보여 주지만, 일에 어떻게 썼는지는 보여 주지 않습니다. 이 글은 그 대신 일한 기록에서 AI를 어떻게 썼는지 보는 항목표와, 평가 면담 질문, 직원 안내문을 담았어요.
직원의 AI 역량은 무엇으로 평가하나요?
AI를 써서 한 일의 기록으로 평가합니다. 볼 것은 AI를 쓴 횟수보다, 쓰는 동안 내린 네 가지 판단입니다. 무엇을 AI에게 맡겼는지, 얼마나 분명하게 지시했는지, 돌아온 결과를 확인했는지, 최종 판단에 책임졌는지.
방법마다 알 수 있는 것과 알 수 없는 것이 다릅니다.
| 방법 | 알 수 있는 것 | 알 수 없는 것 |
|---|---|---|
| 자기평가 설문 (‘AI를 얼마나 쓰나요’) | 본인이 생각하는 사용 빈도와 자신감 | 실제로 잘 쓰는지. 자기평가와 수행 점수는 잘 맞지 않음 (다음 섹션) |
| 라이선스·사용량 집계 | 회사 도구에서 요청한 횟수 | 개인 AI 도구 사용, 결과를 확인했는지 |
| 교육 이수·자격시험 | 개념을 아는지, 정해진 문제를 푸는지 | 자기 일에서 쓰는 방식 |
| 일한 기록 (문서·이슈·팀 채널·코드) | 맡긴 범위, 확인한 흔적, 결과물에 적은 AI 사용 범위 | 공유 기록에 드러나지 않는 판단 (면담에서 확인) |
이 글은 네 판단을 위임·설명·분별·성실이라고 부릅니다. CoSprint의 AI 활용 기준 PAIR의 네 요소이고, CoSprint People도 리뷰마다 같은 네 요소로 AI 활용을 봅니다.
사용 횟수나 자기평가 설문으로 점수를 주면 왜 안 되나요?
둘 다 AI를 잘 쓰는지와 다른 것을 잽니다. 자기평가는 실제 수행과 잘 맞지 않고, 사용량은 회사가 준 도구 안의 횟수만 셉니다.
자기평가부터 보면, AI를 쓰며 논리 문제 20개를 푼 246명은 실제 점수보다 4점 높게 자기 점수를 짐작했고, 452명을 본 두 번째 연구에서도 같은 결과가 나왔습니다.[1] 대학생 355명을 본 연구에서는 20문항 시험 점수가 ‘ChatGPT를 얼마나 잘 쓰는지’에 대한 자기 인식보다 생성형 AI를 쓰는 과제의 성과를 더 잘 예측했고,[2] 교사의 AI 활용 능력을 본 연구도 자기 보고와 문항으로 잰 실제 수준 사이의 상관이 낮다고 보고했습니다.[3]
세 연구 모두 한국 직장인 표본은 아니지만, 결과의 방향은 같습니다. 설문 점수만으로 평가 등급을 매기기는 어렵다고 봅니다.
사용량에는 회사 밖 도구가 빠집니다. 마이크로소프트·링크드인이 2024년 31개국 지식노동자 31,000명에게 물은 결과, AI를 쓰는 사람의 78%가 회사가 주지 않은 자기 AI 도구를 업무에 가져와 썼습니다. 중소기업에서는 80%였습니다.[4] 회사 라이선스 대시보드는 이 사용을 세지 못합니다.
많이 쓰는 것과 잘 확인하는 것도 다릅니다. 47개국 48,000여 명을 조사한 KPMG·멜버른대 연구에서 직장인 응답자의 66%가 정확성을 따져 보지 않고 AI 결과를 쓴다고 답했고, 57%는 AI 사용을 숨기고 AI가 만든 결과물을 자기 것으로 낸다고 답했습니다.[5] 지식노동자 319명의 응답을 분석한 연구에서는 생성형 AI를 더 믿는 사람일수록 비판적 사고를 덜 했다고 답했습니다.[6]
그러면 볼 것은 AI를 써서 한 일의 기록입니다. 다만 직원 60명의 반년치 문서, 이슈, 팀 채널에서 AI를 쓴 대목을 찾아 네 요소로 나눠 읽는 일은, 피플팀 1명이 연말평가 시즌 안에 끝내기 어려운 양입니다.
CoSprint People은 회사가 연결한 업무 도구의 기록에서 리뷰마다 AI 활용을 위임·설명·분별·성실 네 요소로 보고, 근거가 된 기록 원문을 인용합니다. 메시지 수·커밋 수·접속 시간 같은 활동량은 점수로 쓰지 않아요.
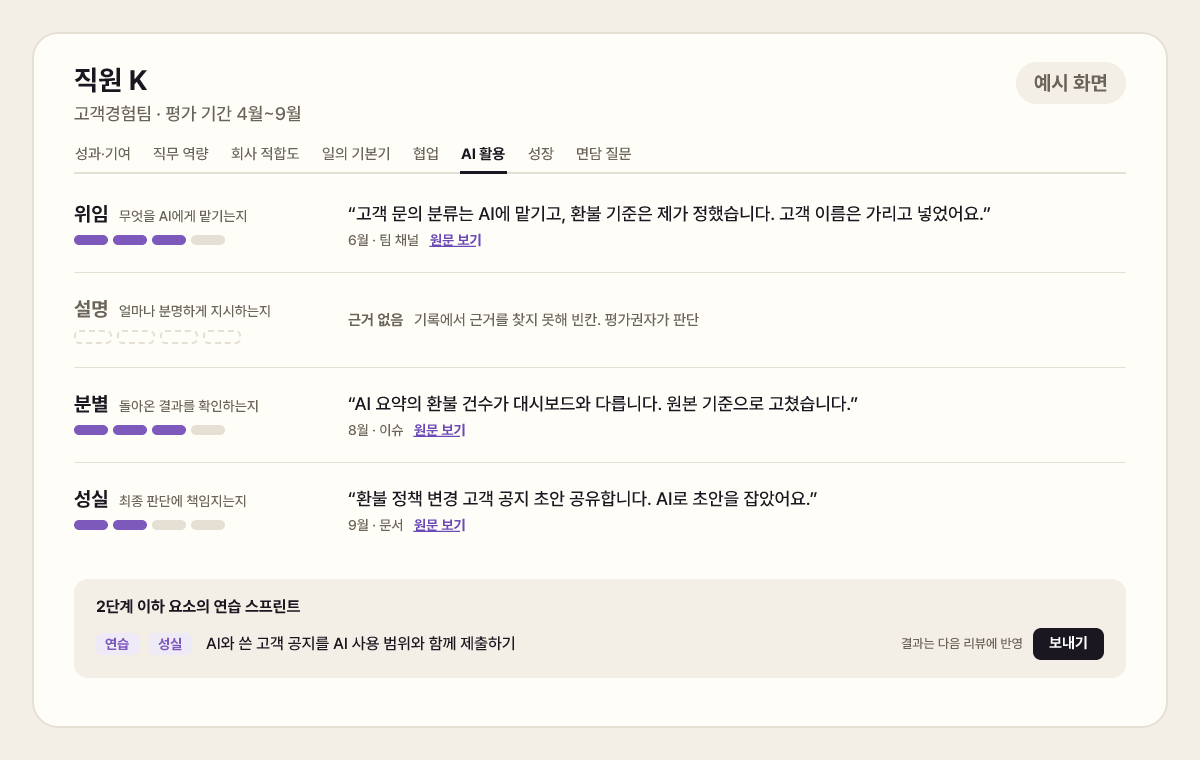
AI 활용 평가 항목표는 어떻게 만드나요?
네 요소마다 1~4단계의 관찰 행동과, 근거로 볼 기록을 적습니다. 기회가 없어 볼 수 없는 요소는 낮은 단계를 주지 않고 ‘근거 없음’으로 비워 둡니다.
단계 이름은 1 기준 미달, 2 기준 충족, 3 우수, 4 탁월입니다. 3단계 칸의 행동이 대부분 보이면 3, 빠짐없이 보이면 4로 봅니다. 아래 예시는 마케팅·운영·개발에 두루 쓰도록 썼으니, 근거로 볼 기록 예는 직무에 맞게 바꿔 쓰세요.
위임: 무엇을 AI에게 맡기는지
| 단계 | 관찰 행동 |
|---|---|
| 1 기준 미달 | 일의 결론이나 추천안을 통째로 AI에게 맡기고 결과를 고치지 않고 냄 |
| 2 기준 충족 | 정리·요약·초안 같은 일은 AI에게 맡기지만, 문제를 정리하지 않고 바로 결과물을 요청하거나 결론의 일부를 AI 문장으로 냄 |
| 3 우수 | 문제와 접근 방법을 먼저 정리한 뒤, AI에게 맡길 부분과 직접 판단할 부분을 나눔. 정리·요약·초안처럼 AI에 맞는 일은 손으로 오래 붙잡지 않고 맡김 |
| 4 탁월 | 3단계에 적은 행동이 빠짐없이 보임 |
고객 개인정보·회사 기밀을 필요 없이 AI에 넣은 기록이 있으면, 다른 행동과 상관없이 위임은 2단계까지로 둡니다. 평가권자가 기록을 열어 사실을 확인한 뒤 반영합니다.
근거로 볼 기록 예: 기획 문서 첫머리의 문제 정리와 작업 분담, PR 설명의 “테스트 초안은 AI, 경계값은 직접 추가”, 데이터를 익명 처리한 뒤 분석을 맡겼다는 팀 채널 메시지
설명: 얼마나 분명하게 지시하는지
| 단계 | 관찰 행동 |
|---|---|
| 1 기준 미달 | 목적이나 맥락 없이 한 줄로 요청하고, 결과가 어긋나면 같은 요청을 되풀이함 |
| 2 기준 충족 | 목적은 적지만 독자, 형식, 범위 같은 조건이 자주 빠짐 |
| 3 우수 | 목적, AI가 모르는 회사 사정과 데이터, 독자, 형식, 분량을 적어 요청함. 결과가 어긋나면 무엇을 바꿀지 짚어 다시 요청함 |
| 4 탁월 | 3단계에 적은 행동이 빠짐없이 보임 |
근거로 볼 기록 예: 팀 위키에 공유한 요청문, 문서에 첨부한 AI 요청 내용, 동료에게 요청문을 설명한 팀 채널 스레드
분별: 돌아온 결과를 확인하는지
| 단계 | 관찰 행동 |
|---|---|
| 1 기준 미달 | AI가 낸 수치나 사실을 확인하지 않고 보고서·고객 메일에 씀. 틀린 내용이 다음 단계로 넘어감 |
| 2 기준 충족 | 눈에 띄는 수치는 확인하지만, 결과물이 기대는 핵심 수치를 빠뜨리기도 함. 근거 없이 AI 결과를 버리거나 다시 손으로 하기도 함 |
| 3 우수 | 결과물이 기대는 수치와 사실을 원본 데이터나 담당자에게 확인한 뒤 씀. AI의 가정에 근거를 들어 반박하고 맞게 고침. 맞는 결과는 다시 하지 않고 씀. AI 결과를 통째로 붙이지 않고 자기 논리 안에 녹여 씀 |
| 4 탁월 | 3단계에 적은 행동이 빠짐없이 보임 |
근거로 볼 기록 예: “AI 요약의 환불 건수가 대시보드와 달라 원본 기준으로 고침” 같은 이슈 코멘트, 데이터 담당자에게 수치를 확인한 스레드, 문서 수정 이력
성실: 최종 판단에 책임지는지
| 단계 | 관찰 행동 |
|---|---|
| 1 기준 미달 | AI가 크게 기여한 결과물에 그 사실을 적지 않음. 확인하지 못한 수치를 사실처럼 씀 |
| 2 기준 충족 | AI를 썼다고는 적지만, 어느 부분에 썼는지나 확인하지 못한 것이 무엇인지는 없음 |
| 3 우수 | 결과물에 AI가 기여한 부분과 사람이 확인한 부분, 확인하지 못한 가정과 한계, 받는 사람에게 생길 위험을 적음 |
| 4 탁월 | 3단계에 적은 행동이 빠짐없이 보임 |
근거로 볼 기록 예: 보고서 끝의 “3쪽 시장 규모는 AI 추정치, 출처 미확인” 표시, 고객에게 보내기 전 검토 요청 메시지, 회고 문서의 AI 사용 범위
이 항목표를 회사 평가표의 다른 기준과 같은 구조로 쓰려면 인사고과 평가표 양식의 기준 행과 근거 칸에 옮겨 쓰면 됩니다. CoSprint People은 일의 기본기·협업·AI 활용을 공통 기준으로 모든 평가에 함께 적용합니다. 회사가 이 표를 따로 만들지 않아도 리뷰마다 AI 활용이 같은 네 요소로 정리됩니다. 채용 과제에서 지원자의 AI 활용을 같은 네 요소로 보는 기준표는 AI 역량 평가 기준표와 면접 질문, 채용 과제로 보는 법에 정리했습니다.
근거가 되는 기록은 어디서 찾나요?
결과물과, 그 결과물을 두고 팀이 나눈 대화에서 찾습니다. 회사가 준 AI 도구(Claude·ChatGPT Enterprise)를 쓴다면 동의한 직원의 업무 대화도 근거가 됩니다. 개인 AI 도구에서 나눈 대화는 보이지 않습니다. 공유 기록에서는 AI 결과를 어떻게 다뤘는지를 봅니다.
| 기록 | 주로 보이는 요소 | 예 |
|---|---|---|
| 문서 (기획서·보고서·회고) 본문과 수정 이력 | 성실, 분별 | AI 추정치와 확인한 수치를 구분한 표시 |
| 이슈 트래커 코멘트 | 분별, 위임 | AI 요약을 원본과 대조해 고친 기록 |
| 팀 채널 스레드 | 분별, 설명 | 데이터 담당자에게 수치 확인 요청, 팀에 공유한 요청문 |
| 코드 저장소 PR 설명·리뷰 | 위임, 분별 | AI에게 맡긴 범위와 직접 확인한 부분 |
| 회사 AI 도구 업무 대화 (동의한 직원만) | 설명, 위임 | 목적·독자·형식을 적은 요청, 고객 이름을 가리고 넣은 요청 |
설명(얼마나 분명하게 지시했는지)은 문서·이슈·채널에는 잘 드러나지 않습니다. 회사 AI 도구의 업무 대화를 근거로 쓰지 않는다면 이 요소에는 빈칸이 많고, 빈칸은 면담 질문으로 확인합니다. CoSprint People은 근거가 빈 기준만 골라 그 사람 직무의 스프린트로 확인할 수도 있습니다.
근거는 회사가 평가에 쓰겠다고 직원에게 알린 공유 기록으로 한정합니다. CoSprint People도 회사가 연결하기로 정한 도구와 채널에서만 기록을 가져오고, DM 등 개인 간 대화는 제외합니다.
평가 면담에서는 AI 활용을 어떻게 물어보나요?
기록에 근거가 없는 요소와 단계 경계에 걸린 요소만 묻습니다. ‘AI를 얼마나 쓰나요’ 대신 최근에 한 일 하나를 골라, 그 일에서 AI에게 무엇을 맡겼는지부터 묻습니다.
| 요소 | 질문 예 |
|---|---|
| 위임 | 이번 분기 보고서에서 AI에게 맡긴 부분과 직접 판단한 부분은 어디였나요? |
| 위임 | AI에 넣지 않기로 한 자료가 있었나요? 어떻게 정했나요? |
| 설명 | 결과가 처음 원하던 것과 달랐을 때, 다음 요청에서 무엇을 바꿨나요? |
| 설명 | 자주 쓰는 요청문이 있다면 함께 볼 수 있을까요? |
| 분별 | AI가 낸 수치 가운데 원본과 대조한 것은 무엇이었나요? |
| 분별 | AI의 답이 틀렸다는 걸 알아챈 적이 있나요? 무엇을 보고 알았나요? |
| 성실 | 이 결과물을 받은 사람은 어디까지 AI가 썼는지 알고 있었나요? |
| 성실 | 확인하지 못한 가정은 결과물 어디에 적었나요? |
답을 들으면 그 일이 기록된 곳도 함께 묻습니다. 기록이 있으면 그 요소의 근거로 옮기고, 없으면 다음 평가 기간에는 결과물에 적어 달라고 요청합니다. 면담 전체를 준비하는 순서는 연말 성과평가 면담 진행법에 정리했습니다.
CoSprint People의 리뷰에는 기록에서 근거를 찾지 못한 기준마다 면담에서 확인할 질문이 함께 정리됩니다.
직원에게는 AI 활용 평가를 어떻게 안내하나요?
무엇을 보고 무엇을 보지 않는지, 그리고 AI 사용을 밝혀도 불리하지 않다는 것을 먼저 씁니다.
AI를 썼다고 밝힌 사람이 밝히지 않은 사람보다 덜 신뢰받는다는 결과가 13개 실험에서 나왔습니다. 같은 연구에서 스스로 밝혀서 잃는 신뢰는, 숨겼다가 다른 사람에게 들켰을 때보다 작았습니다.[8] 앞의 KPMG·멜버른대 조사에서도 직장인 응답자의 57%가 AI 사용을 숨기고 AI 결과물을 자기 것으로 낸다고 답했습니다.[5] 성실 요소는 결과물에 AI 사용 범위를 적어야 근거가 생기니, 적는 것이 감점이 아니라는 문장이 안내문에 들어가야 합니다.
안내문 예시
제목: [인사평가] 올해부터 AI 활용을 평가 기준에 넣습니다
올해 연말평가부터 ‘AI 활용’을 평가 기준에 넣습니다. AI를 얼마나 자주 썼는지는 보지 않습니다. 사용 횟수, 접속 시간, 라이선스 사용량은 평가에 쓰지 않습니다.
평가는 업무 도구에 공유된 결과물과 기록으로 합니다. 네 가지를 봅니다. 무엇을 AI에게 맡겼는지, 얼마나 분명하게 지시했는지, 돌아온 결과를 확인했는지, 최종 판단에 책임졌는지입니다. DM 등 개인 간 대화는 보지 않습니다.
AI를 쓴 결과물에는 AI가 기여한 부분과 직접 확인한 부분을 적어 주세요. 예: “초안은 AI, 3쪽 수치는 원본 대시보드와 대조함”. AI 사용을 밝혀서 불리해지는 일은 없습니다.
AI를 쓰지 않았다는 사실만으로 감점하지 않습니다. 다만 정리·요약처럼 AI에 맡기기 좋은 일을 오래 손으로 한 기록은 위임 항목의 근거로 봅니다. 기록에서 근거를 찾지 못한 항목은 평가 면담에서 확인합니다.
평가 결과의 최종 등급은 평가권자가 정합니다. 궁금한 점은 피플팀에 물어 주세요.
CoSprint People을 쓴다면 시작 전에 어떤 기록을 왜 가져오는지 직원에게 알려야 하고, 안내문 초안은 CoSprint People이 만들어 드립니다. 직원에게 함께 나눠 줄 자기평가서가 필요하다면 인사평가 자기평가 양식과 작성 가이드의 양식에 같은 기준 이름을 쓰세요.
AI 활용 단계가 낮게 나온 직원은 어떻게 하나요?
등급에 반영할지와 별개로, 낮은 요소를 그 사람의 일로 연습하게 합니다. 일반 AI 교육은 개념을 배우는 데 쓰고, 연습 과제는 그 사람이 다음 분기에 할 일과 같은 종류로 고릅니다.
| 낮은 요소 | 직무 | 연습 과제 예 |
|---|---|---|
| 분별 | 마케터 | AI가 쓴 주간 리포트를 임원 보고 전에 검증하기. 원본과 대조한 수치를 리포트에 표시 |
| 성실 | 마케터 | AI와 쓴 캠페인 브리프를 AI 사용 범위와 함께 제출하기 |
| 위임 | 운영 담당 | 고객 문의 분류를 AI에 맡기되, 고객 정보를 가린 데이터로 맡기고 분류 기준은 직접 정하기 |
| 설명 | 개발자 | 다음 릴리스 노트 초안을 요청할 때 독자, 분량, 빼야 할 내부 정보를 적은 요청문을 PR에 함께 올리기 |
연습 결과는 다음 평가 기간의 근거로 씁니다. 첫 시즌에는 AI 활용 단계를 보상과 바로 잇기보다 이 연습의 출발점으로 쓰기를 권합니다.
CoSprint People은 2단계 이하인 요소에 그 사람 직무로 만든 연습 스프린트를 보낼 수 있고, 결과는 다음 리뷰에 반영됩니다.
AI 활용 평가를 매번 손으로 하면 무엇이 어렵나요?
항목표와 질문은 엑셀과 문서로 충분하지만, 근거를 모으는 데서 시간이 듭니다.
- 기록 찾기가 직원 수만큼 네 번씩입니다. 60명이면 240칸의 근거를 문서, 이슈, 채널, 코드에서 따로 찾습니다.
- 팀장마다 읽는 눈이 다릅니다. 같은 이슈 코멘트도 팀장에 따라 분별 3단계로도, 2단계로도 읽힐 수 있습니다. 관리자 4,492명이 상사·동료·부하 직원에게 받은 평가를 분석한 연구에서는, 점수 차이의 절반 이상(두 표본에서 62%, 53%)이 평가하는 사람의 성향에서 나왔고, 평가받는 사람의 실제 성과에서 나온 몫(21%, 25%)은 그 절반에도 못 미쳤습니다.[9] 맞추려면 보정 회의가 한 번 더 필요합니다.
- 빈칸 정리가 따로 듭니다. 근거가 없는 요소를 골라 면담 질문으로 바꾸는 일은 팀장에게 넘기기 전에 피플팀이 해야 합니다.
- 분기마다 다시 합니다. 연습 결과가 다음 리뷰에 들어가려면 평가 주기마다 같은 일을 반복합니다.
근거를 찾는 일이 줄어야 AI 활용 평가를 연말 한 번이 아니라 분기마다 할 수 있습니다.
CoSprint People은 직원의 AI 활용을 어떻게 평가하나요?
CoSprint People은 팀이 이미 쓰는 업무 도구(메신저, 이슈 트래커, 문서, 코드 저장소, 디자인 파일)를 관리자 계정으로 연결하고, 평가 기간 전체의 기록에서 기준마다 근거를 찾아 원문을 인용한 리뷰를 직원마다 만듭니다.
AI 활용은 일의 기본기·협업과 함께 모든 평가에 들어가는 공통 기준입니다.
| 무엇 | 어떻게 |
|---|---|
| 평가 요소 | 리뷰마다 위임·설명·분별·성실 네 요소 |
| 근거 | 요소마다 기록 원문 인용과 원래 도구로 가는 링크. 근거가 없는 요소는 빈칸으로 두고 평가권자가 판단 |
| 쓰지 않는 것 | 메시지 수·커밋 수·접속 시간 같은 활동량. DM 등 개인 간 대화, 화면, 키 입력은 수집하지 않음 |
| 낮은 요소 | 2단계 이하인 요소에 그 사람 직무로 만든 연습 스프린트를 보냄. 결과는 다음 리뷰에 반영 |
| 최종 결정 | 등급, 보상, 승진은 평가권자가 정함 |
회사의 인재상이나 직무 기술서를 올리면 직무별 기준 초안도 함께 만들어, AI 활용과 직무 기준을 한 리뷰에서 볼 수 있습니다. 기준을 만드는 과정은 인사평가 기준표에, 인사 담당자의 평가 시즌이 어떻게 달라지는지는 인사 담당자를 위한 인사평가에 정리했어요.
현장 영업이나 외근처럼 일이 업무 도구에 거의 기록되지 않는 직무가 대부분인 회사라면 People이 찾을 근거가 적습니다. 그런 회사는 이 글의 항목표와 면담 질문으로 시작하는 편이 맞습니다.
자주 묻는 질문
AI를 쓰지 않는 직원은 낮은 단계를 받나요?
AI를 쓰지 않았다는 사실만으로 감점하지 않습니다. AI에 맡긴 일이 없으면 설명·분별은 '근거 없음'으로 비워 두고 면담에서 확인합니다. 위임도 비워 두지만, 정리·요약처럼 AI에 맡기기 좋은 일을 오래 손으로 한 기록이 있으면 그 기록으로 위임 단계를 매깁니다. 성실은 결과물에 확인하지 못한 가정과 한계를 적었는지로 봅니다.
AI 활용 항목의 비중은 얼마로 두나요?
회사가 정합니다. 처음 도입하는 시즌에는 AI 활용 단계를 등급에 크게 섞기보다, 다른 기준과 따로 보여 주고 낮은 요소의 연습 계획을 세우는 데 쓰기를 권합니다. 직원과 팀장 모두 기준에 익숙해진 뒤 비중을 정해도 늦지 않습니다.
고객 정보나 회사 기밀을 AI에 넣은 기록이 나오면 어떻게 하나요?
무엇을 AI에 맡기는지에는 데이터도 들어갑니다. 위임 요소에서 다룹니다. 예시 번호나 가짜 데이터가 섞여 잘못 읽히는 경우도 있으니, 평가권자가 기록을 열어 사실을 확인한 뒤 반영합니다. 회사 정보보호 규정 위반 여부는 평가와 별도 절차로 처리합니다.
AI 역량 진단 시험이나 자격증 결과는 어디에 쓰나요?
AI 개념과 기본 사용법을 아는지 확인하고 교육 대상을 고르는 데 쓰기 좋습니다. 자기 일에서 AI를 어떻게 쓰는지는 시험 점수로 대신하기 어려우니, 인사평가의 AI 활용 근거는 일한 기록에서 찾습니다.
직무마다 AI 활용 기준을 따로 만들어야 하나요?
네 요소와 단계 설명은 모든 직무에 같이 쓰고, '근거로 볼 기록 예'만 직무별로 바꿉니다. 개발자는 PR 설명과 리뷰, 마케터는 캠페인 문서와 보고서, 운영은 이슈 코멘트처럼 그 직무가 주로 쓰는 도구에서 예를 고릅니다.
CoSprint에서 보기
출처
- Fernandes, Villa, Nicholls, Haavisto, Buschek, Schmidt, Kosch, Shen & Welsch (2026), AI makes you smarter but none the wiser: The disconnect between performance and metacognition, Computers in Human Behavior 175, 108779 — 연구 1: 246명이 AI를 쓰며 LSAT 논리 문제 20개를 풂. 실제 점수보다 4점 높게 자기 점수를 짐작. 연구 2(452명)에서 같은 결과 (초록)
- Jin, Martinez-Maldonado, Gašević & Yan (2025), GLAT: The Generative AI Literacy Assessment Test, Computers and Education: Artificial Intelligence 9, 100436 — 대학생 355명. 20문항 시험 점수가 생성형 AI를 쓰는 과제 성과를 자기 인식(ChatGPT 숙련도)보다 더 잘 예측 (초록)
- Zhang, Xiao, Botelho, Liao, Chiu, Stamper & Koedinger (2026), How to Assess AI Literacy: Misalignment Between Self-Reported and Objective-Based Measures, Proceedings of LAK26, 405–414 — 교사 대상. 자기 보고와 객관 측정(문항으로 잰 수준) 요인 사이의 상관이 낮고, 과대평가·과소평가 집단이 나뉨 (초록)
- Microsoft & LinkedIn (2024), 2024 Work Trend Index Annual Report: AI at Work Is Here. Now Comes the Hard Part — 31개국 지식노동자 31,000명, 2024년 2~3월. AI 사용자의 78%가 회사가 주지 않은 자기 AI 도구를 업무에 가져옴(중소기업 80%)
- KPMG & University of Melbourne (2025), Trust, attitudes and use of artificial intelligence: A global study 2025 (KPMG 보도자료) — 47개국 48,000여 명, 2024년 11월~2025년 1월. 66%가 정확성을 따져 보지 않고 AI 결과를 씀, 57%가 AI 사용을 숨기고 AI 결과물을 자기 것으로 냄
- Lee, Sarkar, Tankelevitch, Drosos, Rintel, Banks & Wilson (2025), The Impact of Generative AI on Critical Thinking, CHI '25 — 지식노동자 319명, 사례 936건 설문. 생성형 AI를 더 믿을수록 비판적 사고를 덜 함 (초록)
- 한국일보 (2026-08-17), 임원도 기술 테스트, 인사평가 3할이 AI... 외국어보다 AI 능력 쳐주는 기업들 — 기업 사례 보도(한글과컴퓨터, 삼성전자 등). 사례 소개로만 사용
- Schilke & Reimann (2025), The transparency dilemma: How AI disclosure erodes trust, Organizational Behavior and Human Decision Processes 188, 104405 — 13개 실험. AI 사용을 밝힌 사람이 밝히지 않은 사람보다 덜 신뢰받음. 제3자에게 드러날 때보다는 약함 (초록)
- Scullen, Mount & Goff (2000), Understanding the latent structure of job performance ratings, Journal of Applied Psychology 85(6), 956–970 — 관리자 2,350명·2,142명이 상사·동료·부하·본인 등 평가자 7명에게 받은 육성 목적 평가 두 표본. 점수 차이 가운데 평가자 고유의 성향 62%·53%, 평가받는 사람의 실제 성과 21%·25% (초록)